Industrie · Lehre · Forschung · Anwendung

Xiangjiang-Labor · Forschungs- und Innovationsinstitut für energieeffizientes heterogenes Rechnen
Energieeffizientes heterogenes Rechnen + chinesische lokale KI-Hardware + Fachmodell-Beschleuniger

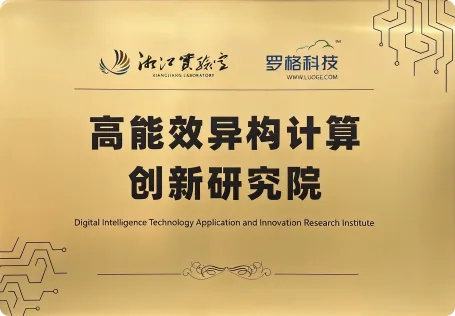
Schild des Forschungs- und Innovationsinstituts für energieeffizientes heterogenes Rechnen

Forschungs- und Innovationsinstitut für energieeffizientes heterogenes Rechnen am Xiangjiang-Labor

Das Forschungs- und Innovationsinstitut für energieeffizientes heterogenes Rechnen am Xiangjiang-Labor ist eine Forschungseinrichtung für Spitzentechnologie mit Fokus auf chinesische kontrollierbare Rechenarchitekturen und KI-Hardwarearchitekturen am Endgerät. Ausgerichtet auf die nationalen strategischen Anforderungen der Rechenindustrie widmet es sich den Fragen der Energieeffizienz und der Eigenständigkeit beim Einsatz von KI am Netzwerkrand und schafft ein solides Rechenfundament für die Initiative „KI+“.

Mit Hard-Software-Kooperation, lokaler Cloud-Integration und höchster Energieeffizienz vereint das Institut Chiphersteller und Industrie zur Lösung zentraler Hardwarefragen. Es erforscht lokale KI-Spezialhardware und chinesische Technologieanpassung für sichere, flüssige lokale Großmodelle statt ausschließlicher Cloudberechnung.

Das Xiangjiang-Labor wurde im Juli 2022 unter Führung der Provinzregierung Hunan als erstes Provinzlabor gegründet. Der Sitz liegt im Beidou-Industriepark der Changsha High-Tech Zone im Xiangjiang New Area. Als bedeutende Innovationsplattform für Advanced Computing und KI wird es von der Wissenschafts- und Technologiebehörde der Provinz Hunan getragen und von der Hunan University of Technology and Business federführend aufgebaut. Die „1346“-Struktur aus Zentrale, Standorten und Innovationszentren umfasst vier Schwerpunkte wie Datenintelligenz und Hochleistungsrechnen sowie sechs Anwendungsfelder wie intelligente Fertigung und intelligente Medizin.

Forschungsprofil

Lokale heterogene Rechenarchitektur für chinesische Chips

Lokale heterogene Rechenarchitektur für chinesische Chips

Vollständiges Ökosystem gemeinsamer Hard-Software-Entwicklung
Vollständiges Ökosystem gemeinsamer Hard-Software-Entwicklung

Von Technologievalidierung zu Produkten und Standards
Von Technologievalidierung zu Produkten und Standards

Gemeinsame F&E mit mehreren Partnern

Gemeinsame F&E mit mehreren Partnern

Forschungsrichtungen
Chinesische lokale Rechenleistung und Geräteprototypen
Chinesische lokale Rechenleistung und Geräteprototypen

Leistungs- und Verbrauchsbenchmarks chinesischer Chips: Rechenleistung, Inferenzgeschwindigkeit, Leistungsaufnahme und Latenz vergleichen und systematische Bewertungsberichte als Grundlage für Auswahl und Kombination erstellen.

Lokale heterogene Prototypen auf chinesischen Chips entwickeln, Hard- und Software integrieren und Steuerung, Stabilität und Leistung unter realen Lasten prüfen.

Standardentwürfe für lokale chinesische KI-Geräte: Benchmarks, Schnittstellen, Sicherheit sowie Energie- und Temperaturtests.

Ressourcenverwaltung und Inferenzsteuerung für stromsparende Hardware erforschen, um Verbrauch und Leistung besser auszugleichen.

Chinesische KI-Frameworks und Inferenzengines
Chinesische KI-Frameworks und Inferenzengines

CANN, MUSA und weitere Frameworks auf chinesischen Chips hinsichtlich Funktionen, Leistung und Anpassungskosten systematisch vergleichen.

Inferenzsteuerung und Operatoren bestehender Frameworks für effizientere lokale und Edge-Anwendungen optimieren.

SDKs, Beispielcode und API-Dokumentation für optimierte Frameworks veröffentlichen, mit sofort nutzbarer Entwicklungsumgebung für Dritte.

Operator-, Steuerungs- und Compileranpassungsstandards definieren, um Modellmigration zwischen chinesischen Plattformen zu erleichtern.

Kleine lokale Modellarchitekturen und energieeffiziente Inferenz
Kleine lokale Modellarchitekturen und energieeffiziente Inferenz

Mamba, Graph Neural Networks (GNN), heterogene Transformer und weitere Architekturen auf lokale Eignung und Leistung untersuchen.

Lokale Inferenzframeworks nach Architekturmerkmalen entwerfen, Operatoren und Steuerung auf chinesischen Chips optimieren.

Kleine effiziente Architekturen untersuchen, die bei gewahrter Genauigkeit Speicher- und Rechenaufwand senken.

Distillation, Quantisierung und Strukturkompression zu lokalen Leichtmodellen kombinieren und Evaluationsstandards entwickeln.

Fine-Tuning kleiner lokaler Branchen- und Fachmodelle

Fine-Tuning kleiner lokaler Branchen- und Fachmodelle

Kleine auf Branchenaufgaben abgestimmte Modelle entwerfen und prüfen, um Genauigkeit und Reaktionstempo zu verbessern.

Hochwertige Branchendatensätze als Grundlage für Training und Fine-Tuning aufbauen.

Evaluationsstandards und Schnittstellenspezifikationen für kleine Modelle in Steuern, Medizin, Recht und weiteren Branchen definieren, damit die Bewertungskriterien über Szenarien hinweg konsistent bleiben.

Dynamische Aufgabensteuerung nach Inferenzkette und Gerätestatus für stabile Leistung bei wechselnden Lasten und Hardwarebedingungen erforschen.

Forschungsergebnisse

Forschungsberichte und technische Whitepaper
Forschungsberichte und technische Whitepaper

Prototypen und Toolchains
Prototypen und Toolchains

Leichtmodelle und kleine Branchenmodelle
Leichtmodelle und kleine Branchenmodelle

Standards und Patente

Standards und Patente