Transforme cada watt de energia
em inteligência confiável
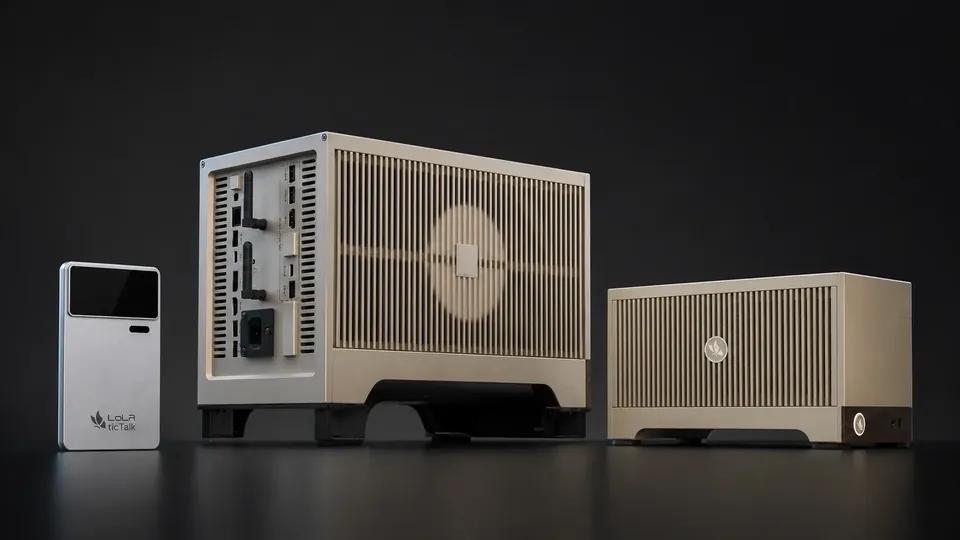
A base confiável começa na camada física: os dados ficam no dispositivo, a inferência é local e a computação pertence à empresa. Por isso, a LoLR.AI desenvolve dispositivos próprios de computação local. Com limites de consumo e tamanho, é preciso aproveitar bem os recursos: FPGA (hardware programável em campo, adaptável a tarefas específicas) e chips aceleradores dedicados complementam a computação geral, distribuindo cargas por tipo de tarefa. A rede distribuída LoLR organiza dispositivos, borda e nuvem em um conjunto orquestrável e auditável.
- CPULógica e orquestração: decisões lógicas complexas, orquestração do sistema e pequenas tarefas não estruturadas.
- GPUInferência paralela: inferência de grandes modelos e operações matriciais paralelas, fornecendo a capacidade central de IA.
- FPGA · Aceleração dedicadaAceleração em pipeline de tarefas frequentes, como gestão de memória, OCR e criptografia, com redução significativa do consumo.
- Orquestração colaborativaDistribuição de cargas por tipo de tarefa; todos os dispositivos executam o mesmo LoLR.AI OS e sistema de Skills.
Conheça toda a linha LoLR HPCs→
CPULógica e orquestraçãoAvaliação de regras · Orquestração do sistema · Pequenas tarefas não estruturadas
GPUAceleração de inferência paralelaInferência de grandes modelos · Operações matriciais paralelas · Capacidade central de IA
FPGAAceleração por hardware dedicadoFPGA e chips aceleradores dedicados · Gestão de memória · OCR · Criptografia
Computação geral em tarefas frequentes
1×
Aceleração por hardware dedicado
10×
Comparação de eficiência energética em tarefas frequentes específicas, como memória, OCR e criptografia, em condições de laboratório; o desempenho do conjunto depende do modelo e do ambiente de uso.
Organização da computação entre dispositivos e nuvem
Um dispositivo tem capacidade limitada, mas as tarefas da empresa se distribuem entre pessoas, departamentos e instituições. A rede distribuída LoLR reúne dispositivos portáteis, desktops, servidores de intranet e nuvem autorizada em uma rede de computação: recursos heterogêneos dividem o trabalho em cada nó, a rede coordena a execução e conexões seguras controlam o fluxo entre nós.
Nós de computação heterogêneaDivisão por tarefa em cada nó: CPU para lógica e orquestração, GPU para inferência paralela, FPGA e chips dedicados para memória, OCR, criptografia e outras tarefas frequentes.
Orquestração distribuídaDefine a execução no dispositivo, borda ou nuvem conforme sensibilidade, latência, tamanho do modelo e custo; coordena os dispositivos da organização conforme a concorrência.
Conexões segurasAutenticação de dispositivos, criptografia de ponta a ponta, controle de acesso e registros completos; dados originais permanecem no nó de origem, enquanto tarefas e conclusões circulam.
Computação distribuída de alta eficiência energéticaHardware dedicado local executa tarefas frequentes próximas da origem; nós departamentais e institucionais concentram a inferência de grandes modelos; a nuvem autorizada atende à demanda elástica, alocando computação conforme a eficiência energética.