Convierta cada vatio
en inteligencia de confianza

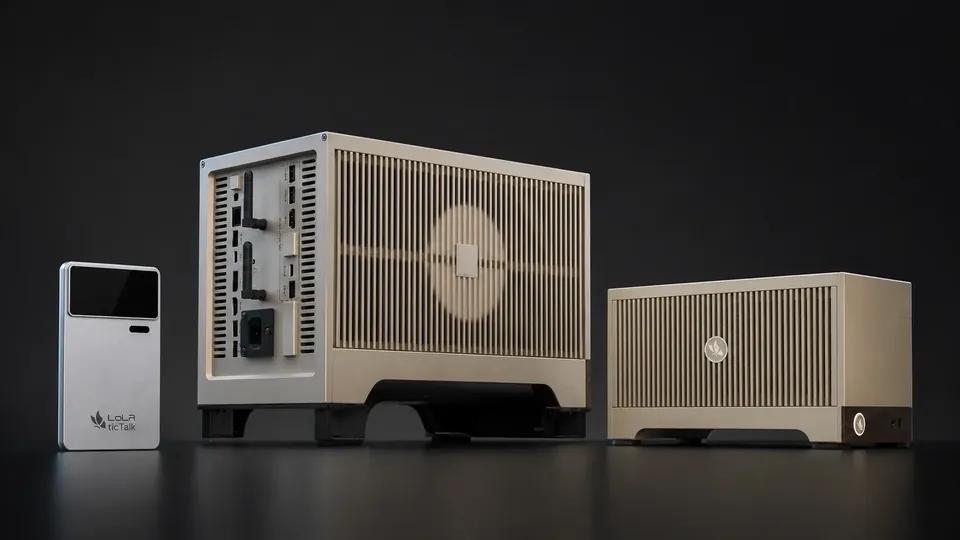
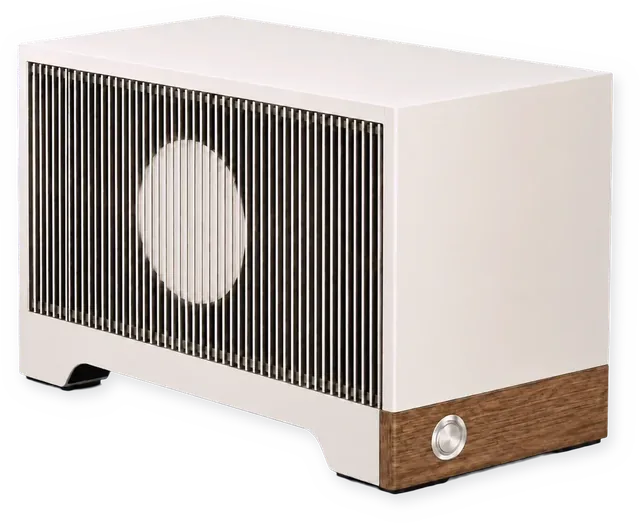
La confianza comienza en la infraestructura física: los datos permanecen en el dispositivo, la inferencia es local y la empresa controla la computación. Por eso LoLR.AI desarrolla sus propios equipos locales. Como el consumo y el tamaño son limitados, cada recurso debe aprovecharse: a la computación general se añaden FPGA —matrices de puertas programables que adaptan el hardware a tareas específicas— y chips aceleradores dedicados, distribuyendo la carga por tipo de tarea. La red distribuida de computación LoLR organiza dispositivos, borde y nube como un conjunto planificable y auditable.

  • CPULógica y planificación: decisiones lógicas complejas, planificación del sistema y pequeñas tareas no estructuradas.
  • GPUInferencia paralela: inferencia de grandes modelos y operaciones matriciales paralelas que aportan la capacidad central de IA.
  • FPGA · Aceleración especializadaAceleración en cadena de tareas frecuentes, como gestión de memoria, OCR y cifrado, que reduce considerablemente el consumo.
  • Planificación coordinadaLas cargas se asignan por tipo de tarea; todos los dispositivos ejecutan el mismo LoLR.AI OS y sistema de Skills.
Conocer toda la familia LoLR HPCs→
CPU
Lógica y planificaciónEvaluación de reglas · Planificación del sistema · Pequeñas tareas no estructuradas
GPU
Aceleración de inferencia paralelaInferencia de grandes modelos · Operaciones matriciales paralelas · Computación central de IA
FPGA
Aceleración de hardware especializadoFPGA y chips aceleradores dedicados · Gestión de memoria · OCR · Cifrado de seguridad
Computación general para tareas frecuentes
1×
Aceleración de hardware especializado
10×

Comparación de eficiencia energética en tareas específicas frecuentes, como gestión de memoria, OCR y cifrado, en condiciones de laboratorio. El rendimiento del equipo depende del modelo y del entorno de uso.

Organización de la computación entre dispositivos y nube

Un dispositivo tiene capacidad limitada; las tareas empresariales se reparten entre personas, departamentos e instituciones. La red distribuida LoLR conecta dispositivos portátiles y de escritorio, servidores internos y nubes autorizadas. Cada nodo distribuye sus tareas entre procesadores heterogéneos, la red coordina la ejecución y los enlaces seguros controlan el intercambio.

Planificación unificada · LoLR.AI OS La sensibilidad de los datos, la latencia, el tamaño del modelo y el coste determinan dónde se ejecuta cada tarea Dispositivo Equipos portátiles y personales LoLR ticTALK · mini · BOX Procesamiento próximo de tareas frecuentes OCR · Transcripción · Búsqueda en memoria · Consultas cotidianas CPU · GPU · FPGA · Aceleración especializada Datos en el dispositivo · Respuesta en milisegundos · Bajo consumo Borde Red interna de departamentos e instituciones LoLR STUDIO · STATION LoLR STATION Soluciones por proyecto · Escala de rack Inferencia de grandes modelos y uso compartido Control de riesgos de cumplimiento · Expertos digitales departamentales · Análisis de todos los datos CPU · GPU · FPGA · Aceleración especializada · Orquestación de varios equipos Todos los datos en el entorno privado · Alta concurrencia · Tecnología informática china Nube Nube autorizada LoLR Cloud · Cómputo público con acceso autorizado LoLR Cloud Computación elástica y actualización de modelos Análisis a gran escala · Razonamiento entre entornos · Actualización de modelos y Skills GPU elásticas · Uso según autorización y políticas de datos Solo tareas autorizadas · Registro de todas las llamadas Enlaces seguros: autenticación de dispositivos · Cifrado de extremo a extremo · Control de permisos · Auditoría completa Los datos originales permanecen en su nodo de origen; entre nodos circulan tareas, conclusiones y capacidades de modelos autorizadas
(Deslice horizontalmente para ver el diagrama completo)
La planificación unificada elige dispositivo, borde o nube; los enlaces seguros controlan los intercambiosRed distribuida de computación LoLR · Esquema
Nodos de computación heterogénea

Dentro de cada nodo, la CPU gestiona lógica y planificación; la GPU, inferencia paralela; y las FPGA y los chips dedicados, tareas frecuentes como memoria, OCR y cifrado.

Planificación distribuida

Elige dispositivo, borde o nube según sensibilidad, latencia, tamaño del modelo y coste; coordina la concurrencia entre los equipos de la organización.

Enlaces seguros

Autenticación de dispositivos, cifrado de extremo a extremo, control de permisos y trazabilidad completa. Los datos originales permanecen en su nodo; circulan tareas y conclusiones.

Computación distribuida de alta eficiencia energética

El hardware local resuelve tareas frecuentes cerca de su origen; los nodos departamentales e institucionales concentran la inferencia de grandes modelos; la nube autorizada atiende demandas elásticas. La computación se asigna según su eficiencia energética.

Base de confianza=Nodos heterogéneos de alta eficiencia energética+Red distribuida de computación+Enlaces segurosAsí se logra soberanía sobre los datos, la computación y el negocio: la empresa conserva los datos, controla los recursos y define sus operaciones.